چگونه رایجترین خطاهای Ollama را برطرف کنیم (و چرا رخ میدهند)
چگونه رایجترین خطاهای Ollama را برطرف کنیم (و چرا رخ میدهند)
Ollama به مسیر ورود پیشفرض برای اجرای مدلهای زبانی بزرگ روی سختافزار خودتان تبدیل شده، با یک مخزن عمومی گیتهاب که از ۱۸۰ هزار ستاره عبور کرده و کتابخانهای از مدلها که از مدلهای کوچک کوانتیزهشده که روی یک لپتاپ اجرا میشوند تا مدلهای وزن-باز عظیمی که به حافظهٔ GPU جدی نیاز دارند را پوشش میدهد. آن محبوبیت بهمعنای طیف عظیمی از سختافزار، سیستمعاملها و ابزارهای پاییندستی — Open WebUI، Cline، AnythingLLM، اسکریپتهای سفارشی — است که همه با همان سرور محلی صحبت میکنند، و دقیقاً به همین دلیل پیامهای خطای Ollama میتوانند از یک API ابری مرموزتر به نظر برسند: هیچ صفحهٔ وضعیت فروشندهای برای بررسی وجود ندارد، و شکست میتواند از خود Ollama، درایور GPU شما، فایروال شما، یا هر کلاینتی که سعی میکند با آن صحبت کند بیاید.
خبر خوب این است که تقریباً هر خطای Ollama گزارششده در سراسر ایشوهای گیتهاب، انجمنهای جامعه و راهنماهای عیبیابی به تعداد کمی علت ریشهای فروکاسته میشود: یک تعارض پورت، مدلی که واقعاً بهدرستی کشیده نشده، یک GPU که بیصدا استفاده نمیشود، تمامشدن VRAM، ناهماهنگی شبکهای میان Ollama و هر چیزی که سعی میکند به آن دسترسی پیدا کند، سرریز آرام پنجرهٔ زمینه، یک دانلود خرابشده، نسخهٔ قدیمی Ollama که فرمت یک مدل جدیدتر را نمیفهمد، یا ناهماهنگی احراز هویت با ویژگیهای ابری Ollama. این راهنما هرکدام را مرور میکند، دلیل واقعی رخدادنش را در پسزمینه توضیح میدهد، و راهحل دقیق را میدهد تا دفعهٔ بعد که Ollama خطایی نشان داد، در چند ثانیه آن را بشناسید بهجای حدسزدن.
بیش از ۱۸۰ هزار
ستارهٔ گیتهاب روی مخزن متنباز ollama/ollama
۱۱۴۳۴
پور�� پیشفرضی که Ollama روی 127.0.0.1 به آن متصل میشود، و رایجترین منبع خطاهای «آدرس از قبل در حال استفاده است» وقتی یک نمونهٔ دوم سعی میکند شروع شود
فقط 127.0.0.1
Ollama بهطور پیشفرض روی localhost گوش میدهد، و دقیقاً به همین دلیل کانتینرهای Docker و کلاینتهای راه دور مکرراً «اتصال رد شد» گزارش میدهند تا زمانی که این صریحاً تغییر کند
بیصدا
چگونگی رهاکردن درخواستها توسط Ollama وقتی یک نشست عاملی طولانی به سقف پنجرهٔ زمینهٔ پیکربندیشده برخورد میکند — بدون هیچ پیام خطا، فقط یک پاسخ رهاشده یا کوتاهشده
۱ دستور
تعداد دستورهای ترمینال لازم برای رفع اکثریت خطاهای پوششدادهشده در این راهنما، وقتی بدانید کدام یک اعمال میشود

چرا خطاهای Ollama از یک شکست API ابری متفاوت به نظر میرسند
وقتی یک API هوش مصنوعی ابری شکست میخورد، یک صفحهٔ وضعیت را بررسی میکنید و صبر میکنید. وقتی Ollama شکست میخورد، شکست میتواند در هرکدام از چهار لایهٔ جداگانهای که شخصاً مالک آنهایید رخ دهد: خود فرآیند سرور Ollama، درایور و سختافزار GPU شما، قوانین شبکهای سیستمعامل شما، یا هر برنامهٔ کلاینتی که سعی میکند به API Ollama دسترسی پیدا کند.
همین لایهبندی است که عیبیابی Ollama را سختتر از آنچه واقعاً هست جلوه میدهد. یک علامت منفرد — «وقتی درخواست میفرستم هیچ اتفاقی نمیافتد» — میتواند یعنی سرور در حال اجرا نیست، روی پورت اشتباه در حال اجراست، در حال اجراست اما کلاینت به آدرس اشتباه اشاره میکند، یا در حال اجرا و قابلدسترسی است اما بیصدا به استنتاج CPUای آنقدر کند بازگشته که به نظر یخزده میرسد. هیچکدام از اینها مسائل عجیبی نیستند، و هرکدام یک گام تشخیصی خاص و سریع دارند، اما مخلوطکردن آنها دلیل این است که چرا اینقدر از موضوعات عیبیابی جامعه با «Ollama کار نمیکند» شروع میشوند بهجای یک علامت دقیق. راهحل آن یک چکلیست کوتاه و مرتب است، که این راهنما در پایان به سمت آن پیش میرود — اما اول، نه خطای خاصی که ارزش شناختن با نام دارند.
خطای ۱: «آدرس از قبل در حال استفاده است» روی پورت ۱۱۴۳۴
این اولین خطایی است که بسیاری از مردم از Ollama میبینند، و همچنین یکی از اطمینانبخشترین خطاها پس از فهمیدن آن است: یعنی Ollama از قبل با موفقیت در حال اجراست، فقط نه نسخهای که اکنون سعی میکنید شروع کنید.
پیام دقیق روی macOS و لینوکس Error: listen tcp 127.0.0.1:11434: bind: address already in use است، یا عبارتپردازی خود سیستمعامل، Only one usage of each socket address is normally permitted، روی ویندوز. هر دو همان رویداد زیربنایی را توصیف میکنند: سرور HTTP Ollama سعی کرد پورت TCP ۱۱۴۳۴ را روی localhost مطالبه کند، و سیستمعامل رد کرد چون فرآیند دیگری از قبل آن را در اختیار دارد — تقریباً همیشه یا اپلیکیشن دسکتاپ Ollama در تری سیستم، یا یک فرآیند ollama serve قبلاً شروعشده که هرگز کاملاً خارج نشده. این پیش از اینکه هیچ مدل یا درخواستی حتی درگیر شود اتفاق میافتد، و به همین دلیل یکی از سادهترین خطاها برای رفع با اطمینان است.
- پیش از فرض اینکه چیزی خراب است، بررسی کنید واقعاً چه چیزی پورت را در اختیار دارد با lsof -nP -iTCP:11434 -sTCP:LISTEN روی macOS/لینوکس، یا netstat -ano | findstr 11434 روی ویندوز
- اگر برنامهٔ دسکتاپ یا آیکون تری Ollama است، آن را کاملاً ببندید بهجای اجرای یک ollama serve دوم در کنار آن — فقط به یک نسخهٔ در حال اجرا نیاز دارید
- اگر واقعاً به یک نمونهٔ دوم روی پورت متفاوتی نیاز دارید، OLLAMA_HOST=127.0.0.1:11435 را بهعنوان متغیر محیطی پیش از اجرای ollama serve تنظیم کنید، و بهیاد داشته باشید هر کلاینتی را به پورت مطابق اشاره دهید
- روی نصبهای systemd لینوکس، سرویس را مستقیم با sudo systemctl edit ollama.service ویرایش کنید بهجای دستوپنجهنرمکردن با فایل واحد پیشفرض، سپس با sudo systemctl daemon-reload && sudo systemctl restart ollama دوبارهراهاندازی کنید
خطای ۲: مدل پیدا نشد (حتی با اینکه همین حالا آن را کشیدید)
پیام model "llama3.2" not found, try pulling it first رایجترین خطا برای تازهواردان به Ollama است، و تقریباً همیشه یک ناهماهنگی نامگذاری است نه چیزی واقعاً خراب.
نامهای مدل Ollama یک برچسب پس از دونقطه حمل میکنند که یک اندازه یا کوانتیزاسیون خاص را مشخص میکند — llama3.2:3b و llama3.2:1b دانلودهای متفاوتی هستند، و ارجاعدادن به یکی وقتی فقط دیگری را کشیدهاید دقیقاً همین خطا را تولید میکند، حتی با اینکه «نسخهای از llama3.2» واقعاً روی ماشین شما وجود دارد. اجرای ollama list دقیقاً نشان میدهد کدام مدلها و برچسبها واقعاً بهصورت محلی حاضرند، که ابهام را در چند ثانیه برطرف میکند. نسخهٔ مرتبط اما متمایزی از این خطا مشخصاً هنگام یکپارچهسازی Ollama با یک ابزار پاییندستی مانند یک وبیوآی یا عامل کدنویسی ظاهر میشود: ابزار یک نام مدل پیکربندیشده دارد که دقیقاً با آنچه ollama list نشان میدهد مطابقت ندارد، اغلب چون یک مدل ارتقا یا تغییرنام یافته بدون بهروزرسانی آن یک فیلد پیکربندی.
اولاما: موتور پشت هوش مصنوعی محلی
اگر هنوز برای اولینبار Ollama را راهاندازی میکنید یا میخواهید پیش از عیبیابی، تصویر کاملتری از اینکه چگونه در یک استک هوش مصنوعی محلی جا میگیرد ببینید، اینجا نقطهٔ شروع خوبی است.
مطالعهٔ معرفی کامل اولاماخطای ۳: اتمام حافظهٔ CUDA / GPU
خطای اتمام حافظه هنگام بارگذاری یا اجرای یک مدل بهندرت یک باگ است — Ollama دقیقاً گزارش میدهد که مدل، بههمراه زمینهٔ فعالش، واقعاً در VRAM موجود روی GPU شما جا نمیشود.
این بیشتر وقتی ظاهر میشود که یک مدل کوچکتر در یک خانواده خوب کار میکند اما نسخهٔ بزرگتر بلافاصله شکست میخورد، یا وقتی مدلی که برای پرامپتهای کوتاه کار میکرد ناگهان همینکه مکالمه یا زمینه رشد میکند شکست میخورد، چون زمینه علاوه بر ردپای خود مدل، VRAM اضافی مصرف میکند. شکست گاهی غیرمستقیم ظاهر میشود — یک ریست اتصال یا یک پاسخ رهاشده بهجای یک رشتهٔ صریح «اتمام حافظه» — که این باعث میشود بهراحتی بهعنوان یک مشکل شبکهای اشتباه تشخیص داده شود درحالیکه واقعاً یک سقف حافظه است. اجرای ollama ps درحالیکه یک مدل بارگذاری شده نشان میدهد کدام لایهها واقعاً روی GPU در برابر CPU هستند، و nvidia-smi (یا معادل آن برای فروشندهٔ GPU شما) مصرف VRAM بلادرنگ را نشان میدهد، که با هم این خطا را ساده برای تأیید بهجای حدسزدن میکنند.
- پیش از فرض اینکه سختافزارتان اصلاً نمیتواند مدلهای محلی را اجرا کند، به تعداد پارامتر کوچکتر یا نسخهٔ بهطور تهاجمیتری کوانتیزهشده از همان خانوادهٔ مدل تغییر دهید
- مقدار زمینهای که از Ollama میخواهید همزمان در حافظه نگه دارد را کاهش دهید، چون تاریخچهٔ مکالمهٔ طولانی مستقیماً برای همان بودجهٔ VRAM با خود مدل رقابت میکند
- برنامههای دیگری که حافظهٔ GPU را در اختیار دارند بررسی کنید — یک مرورگر با شتاب سختافزاری، یک بازی، یا یک سرور مدل دیگر همگی میتوانند بیصدا در همان استخری که Ollama نیاز دارد بخورند
- اگر یک راهاندازی ترکیبی CPU/GPU اجرا میکنید، با ollama ps تأیید کنید واقعاً چند لایه به GPU منتقل میشوند بهجای فرض بهرهبرداری کامل GPU بهطور پیشفرض
خطای ۴: اجرای Ollama روی CPU بهجای GPU (کندی بیصدا)
برخلاف بیشتر خطاهای این راهنما، این یکی اصلاً پیام خطایی تولید نمیکند — یک پاسخ کارآمد اما بهطرز رنجآوری کند تولید میکند، و بسیاری از مردم هفتهها به همین شکل اجرا میکنند پیش از اینکه متوجه شوند GPUشان هرگز واقعاً استفاده نشده.
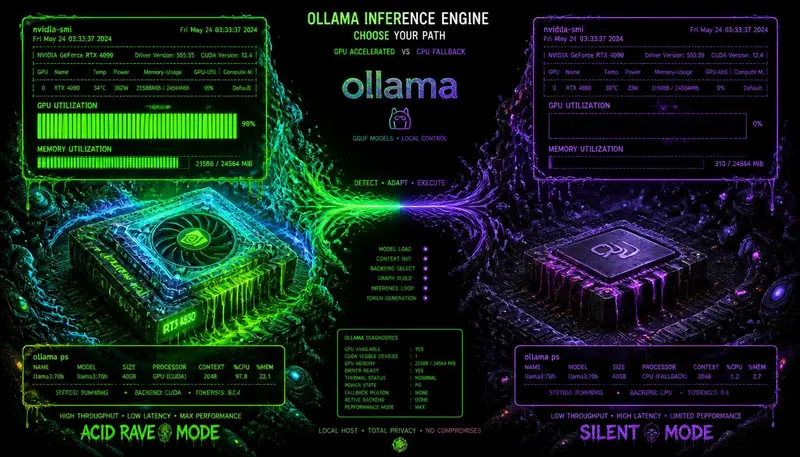
روی مکهای اپل سیلیکون، Ollama بهطور خودکار از Metal استفاده میکند و این حالت شکست نادر است. روی ویندوز و لینوکس با یک GPU انویدیا، بهمراتب رایجتر است، و معمولاً به یک درایور CUDA قدیمی یا موجودنبودن، یک GPU که رانتایم Ollama آن را نمیشناسد، یا مدلی که برای جایگرفتن در VRAM خیلی بزرگ است و بیصدا به اجرای جزئی یا کامل CPU برمیگردد بهجای شکستخوردن آشکار برمیگردد. سریعترین راه برای تأیید اینکه واقعاً چه اتفاقی میافتد این است که یک پرامپت را اجرا کنید و همزمان nvidia-smi را در یک ترمینال جداگانه تماشا کنید — اگر بهرهبرداری GPU درحالیکه پاسخی تولید میشود نزدیک صفر باقی بماند، مدل روی CPU در حال اجراست فارغ از آنچه لاگهای خود Ollama ممکن است نشان دهند.
اوپن وبیوآی: رابط کاربری گمشده برای هوش مصنوعی محلی
اگر Ollama را بهشکل headless اجرا میکنید و میخواهید یک رابط چت مناسب با مدیریت مدل، RAG و پشتیبانی چندکاربره روی آن لایهبندی شود، اینجا راهاندازی را پوشش میدهد.
مطالعهٔ راهنمای Open WebUIخطای ۵: اتصال رد شد از Docker، یک وبیوآی، یا یک عامل کدنویسی
Ollama بهطور پیشفرض به دلایل امنیتی روی 127.0.0.1 گوش میدهد، و همین یک تصمیم طراحی علت ریشهای تقریباً هر گزارش «نمیتوانم به Ollama متصل شوم» از یک کلاینت در حال اجرا درون Docker یا روی ماشین دیگری در شبکه است.
درون یک کانتینر Docker، localhost به خود کانتینر اشاره میکند، نه ماشین میزبانی که Ollama واقعاً روی آن اجرا میشود — و به همین دلیل یک ابزار کانتینری مانند AnythingLLM یا یک اسکریپت ��فارشی به http://host.docker.internal:11434 نیاز دارد بهجای آدرس localhost که بیرون یک کانتینر خوب کار میکند. برای دسترسی راه دور واقعی از دستگاه دیگری در شبکهتان، Ollama باید گفته شود به هر رابط شبکهای متصل شود بهجای فقط localhost، با تنظیم OLLAMA_HOST=0.0.0.0:11434 پیش از شروع سرور. آن تغییر با یک مصالحهٔ امنیتی واقعی همراه است که ارزش جدیگرفتن دارد: API Ollama هیچ احراز هویت داخلیای ندارد، پس افشای آن فراتر از localhost یعنی هر چیزی که بتواند به آن پورت در شبکهتان دسترسی پیدا کند میتواند از مدلهای شما استفاده کند، و دقیقاً به همین دلیل یک قانون فایروال یا یک reverse proxy جلوی آن، ارزش راهاندازی همان لحظه که این تغییر را انجام میدهید را دارد، نه پس از اینکه چیزی اشتباه پیش برود.
خطای ۶: پنجرهٔ زمینه بهآرامی نشستهای طولانی را کوتاه میکند
این دستهٔ خطایی است که اصلاً خودش را اعلام نمیکند — یک نشست عاملی طولانی یا مکالمهٔ گسترده بهسادگی درست پاسخدادن را متوقف میکند، یا یک پاسخ بیصدا محتوا را رها میکند، همینکه زمینهٔ انباشتهشده از سقف پنجرهٔ زمینهٔ پیکربندیشدهٔ Ollama عبور کند.
این بیشتر وقتی بهطور مشهود ظاهر میشود که Ollama بهعنوان بکاند برای یک ابزار کدنویسی عاملی در حال اجرای وظایف طولانی و چندمرحلهای استفاده میشود، چون آن ابزارها تاریخچهٔ مکالمهٔ انباشتهشده و نتایج ابزار را با هر گام دوباره میفرستند، و طول زمینهٔ پیشفرض Ollama میتواند بهطور قابلتوجهی کوچکتر از آنچه یک حلقهٔ عاملی طولانی واقعاً نیاز دارد باشد. تنظیم OLLAMA_CONTEXT_LENGTH به یک مقدار بزرگتر (۱۳۱۰۷۲ انتخاب رایجی برای نشستهای واقعاً طولانی است) پیش از شروع ollama serve مستقیماً آن سقف را بالا میبرد، به قیمت مصرف حافظهٔ اضافی بهازای هر مدل بارگذاریشده. چون این حالت شکست بیصدا است نه اعلامشده، ارزش دارد هر کوتاهشدگی یا پاسخ رهاشدهٔ توضیحندادنی در طول یک نشست طولانی را ابتدا بهعنوان مظنون طول زمینه در نظر بگیرید، پیش از فرض اینکه خود مدل بدرفتاری میکند.
چگونه رایجترین خطاهای Cline را برطرف کنیم (و چرا رخ میدهند)
مسائل پنجرهٔ زمینه منحصر به Ollama نیستند — دقیقاً همان حالت شکست هنگام اجرای هر مدل محلی یا ابری از طریق یک ابزار کدنویسی عاملی ظاهر میشود. ارزش دارد در کنار این راهنما بخوانید اگر Ollama را با Cline جفت میکنید.
مطالعهٔ راهنمای عیبیابی Clineخطای ۷: دانلود خراب یا ناقص مدل
Ollama همیشه یک دانلود ناقص یا خراب را بهطور خودکار تشخیص نمیدهد، و یک کشیدن قطعشده — یک اتصال رهاشده، یک درپوش لپتاپ بستهشده، یک فرآیند کشتهشده — میتواند یک فایل مدل باقی بگذارد که در ollama list حاضر به نظر میرسد اما همینکه واقعاً استفاده میشود شکست میخورد یا خروجی نامفهوم تولید میکند. این یکی از سادهترین خطاها در کل این راهنما برای رفع و یکی از آسانترینها برای اشتباهتشخیصدادن بهعنوان چیزی پیچیدهتر است: حذف مدل تحتتأثیر با ollama rm <model-name> و کشیدن دوبارهٔ تازه با ollama pull <model-name> اکثریت قریببهاتفاق موارد را حل میکند، و ارزش امتحانکردن پیش از صرف زمان برای عیبیابی چیز پیچیدهتری را دارد وقتی یک مدل خاص عجیب رفتار میکند درحالیکه دیگران روی همان ماشین خوب کار میکنند.
خطای ۸: «معماری مدل ناشناخته» درست پس از کشیدن یک مدل جدید
وقتی یک خانوادهٔ مدل واقعاً جدید با معماریای که نسخهٔ فعلی Ollama هنوز نمیشناسد عرضه میشود، نتیجه یک خطای خاص و بسیار لفظی است: Ollama به شما میگوید نمیداند به چه چیزی نگاه میکند.
این بارها اتفاق افتاده چون معماریهای مدل جدید سریعتر از بهروزرسانی نصب محلی Ollama توسط برخی کاربران عرضه میشوند، و علت زیربنایی دقیقاً همان چیزی است که خطا القا میکند: اجزای اجرای مدل Ollama در برابر نسخهٔ خاصی از موتور استنتاج زیربنایی کامپایل شدهاند، و یک رشتهٔ معماری کاملاً جدید بهسادگی هنوز در واژگان آن نسخه نیست. راهحل تقریباً همیشه یک بهروزرسانی نسخهٔ ساده است — اجرای آخرین نصبکننده برای پلتفرم شما، یا بازسازی از سورس با یک وابستگی بهروزشده اگر در یک راهاندازی از-سورس هستید — نه چیزی نادرست در فایل مدل خاصی که کشیدید. بررسی یادداشتهای انتشار یک مدل جدید برای حداقل نسخهٔ موردنیاز Ollama پیش از کشیدن آن، یک انحراف عیبیابی واقعاً گیجکننده را صرفهجویی میکند، چون خود پیام خطا همیشه ناهماهنگی نسخه را آشکار نمیکند.

خطای ۹: Ollama Cloud 401 غیرمجاز
برای مدلهای ارائهشده از طریق پیشنهادهای برچسب-ابری Ollama بهجای اجرای کاملاً محلی، یک خطای ۴۰۱ تقریباً همیشه یعنی توکن احراز هویت بهدرستی برداشت نمیشود نه یک مشکل واقعی حساب. اجرای ollama signin آن اتصال را دوباره برقرار میکند، و ollama ls تأیید میکند آیا مدلهای برچسب-ابری اکنون بهعنوان قابلدسترسی نشان داده میشوند. اگر خطا پس از ورود دوباره ادامه یابد، بررسی اینکه فایل کلید محلی با آنچه در صفحهٔ تنظیمات حسابتان ثبت شده مطابقت دارد بیشتر موارد باقیمانده را حل میکند — و ارزش دارد در برابر غریزهٔ حذف و بازتولید آن فایل کلید بهعنوان اولین گام عیبیابی مقاومت کنید، چون این کار میتواند احراز هویت را روی ماشینهای دیگری که از قبل از همان حساب استفاده میکنند خراب کند بهجای اینکه فقط آنکه اکنون شکست میخورد را رفع کند.
راهنمای عیبیابی Ollama — مرجع جامعه
برای خطاهایی که اینجا پوشش داده نشدهاند، یا علائم خاص یک خانوادهٔ مدل خاص، این راهنمای مستقل موارد لبهٔ اضافی را که مستقیماً در برابر انتشارات اخیر Ollama بازتولید شدهاند پوشش میدهد.
مطالعهٔ راهنمای کامل جامعهچکلیست تشخیصی ۳۰ ثانیهای پیش از کاوش بیشتر
بیشتر مشکلات Ollama را میتوان سریع با گذراندن همان توالی کوتاهی که کاربران باتجربه بهطور پیشفرض انجام میدهند تریاژ کرد، بهجای پریدن مستقیم به یک توضیح عجیب. اول، تأیید کنید سرور واقعاً در حال اجرا و اصلاً قابلدسترسی است با بازکردن http://127.0.0.1:11434 در یک مرورگر — یک سرور کارآمد با متن ساده «Ollama is running» پاسخ میدهد، و هر چیز دیگری یعنی خود سرور مشکل است، نه هیچ مدل یا کلاینت خاصی. دوم، اگر سرور پاسخ میدهد اما یک مدل خاص نه، ollama list را اجرا کنید و نام و برچسب دقیق مدل را در برابر آنچه کلاینتتان درخواست میکند بررسی کنید، چون ناهماهنگی برچسب پشت سهم نامتناسبی از گزارشهای «مدل پیدا نشد» است. سوم، اگر یک مدل بارگذاری میشود اما بهطور عجیبی کند پاسخ میدهد، nvidia-smi یا مانیتور GPU پلتفرم خود را در طول تولید بررسی کنید تا یک بازگشت بیصدا به CPU را پیش از فرض هر چیز دیگری رد کنید. چهارم، اگر کلاینتی در حال اجرا درون Docker یا روی ماشین دیگری اصلاً نمیتواند متصل شود، تأیید کنید آیا از آدرس درست برای آن زمینه استفاده میکنید — host.docker.internal برای کانتینرها، یک اتصال صریح 0.0.0.0 برای دسترسی راه دور واقعی — بهجای فرض اینکه خود Ollama خراب است. آن توالی کوتاه اکثریت بزرگی از آنچه در سراسر ایشوهای گیتهاب و موضوعات عیبیابی جامعهٔ Ollama ظاهر میشود را پیش از اینکه هرگز نیاز به نگاه عمیقتر داشته باشید حل میکند.
الگوی پشت تقریباً هر خطای Ollama
متن خطای خاص را کنار بگذارید، تقریباً همهٔ شکستهای رایج Ollama به یکی از سه چیز برمیگردند: یک سقف منبع که بهآرامی برخورد شده (پورت، VRAM یا طول زمینه)، یک فرض شبکهای که در راهاندازی خاص شما پایدار نمیماند (Docker، دسترسی راه دور، فایروال)، یا یک ناهماهنگی نسخه میان Ollama و هر چیزی که از آن خواسته میشود اجرا کند یا با آن صحبت کند.
هیچکدام از اینها یک ترمینال یخزده یا یک پاسخ بهطرز مرموزی کند را در همان لحظه کمتر آزاردهنده نمیکند. اما به این معناست که راهحل بهندرت یک معمای واقعی است. تأیید کنید سرور واقعاً قابلدسترسی است، نام دقیق مدل را در برابر ollama list بررسی کنید، بهرهبرداری GPU را تماشا کنید بهجای فرضکردن آن، آدرس شبکهای درست را برای هر چیزی که سعی میکند متصل شود بگیرید، و خود Ollama را نسبتاً بهروز نگه دارید در برابر انتشارات مدل جدید. با هم، آن فهرست کوتاه اکثریت قریببهاتفاق آنچه در ردیاب ایشوی خود Ollama ظاهر میشود را حل میکند — و ارزش دارد پیش از فرض اینکه یک باگ واقعاً جدید پیدا کردهاید آن را اجرا کنید، چون احتمال زیادی وجود دارد راهحل از قبل در همین راهنما نشسته باشد.
(سؤالات متداول)
چرا Ollama میگوید «آدرس از قبل در حال استفاده است» وقتی ollama serve را اجرا میکنم؟
این یعنی Ollama از قبل در حال اجراست — یا برنامهٔ دسکتاپ تری یا یک فرآیند ollama serve قبلی که هرگز کاملاً خارج نشده — و از قبل پورت ۱۱۴۳۴ را در اختیار دارد. بررسی کنید چه چیزی پورت را استفاده میکند با lsof -nP -iTCP:11434 -sTCP:LISTEN روی macOS/لینوکس، یا netstat -ano | findstr 11434 روی ویندوز، سپس نمونهٔ موجود را ببندید بهجای تلاش برای اجرای یک دومی، یا OLLAMA_HOST را به پورت متفاوتی تنظیم کنید اگر واقعاً به دو نمونهٔ در حال اجرا نیاز دارید.
چرا Ollama میگوید یک مدل پیدا نشده وقتی از قبل آن را کشیدهام؟
تقریباً همیشه یک ناهماهنگی برچسب است. نامهای مدل Ollama یک برچسب پس از دونقطه شامل میشوند که اندازه یا کوانتیزاسیون را مشخص میکند، مانند llama3.2:3b در برابر llama3.2:1b، و اینها بهعنوان دانلودهای کاملاً جداگانه در نظر گرفته میشوند. ollama list را اجرا کنید تا دقیقاً ببینید کدام مدلها و برچسبها واقعاً حاضرند، و تأیید کنید کلاینت یا دستورتان دقیقاً به همان نام و برچسب ارجاع میدهد.
چرا Ollama حافظهاش تمام میشود درحالیکه GPUام باید بهاندازهٔ کافی بزرگ باشد؟
زمینه علاوه بر ردپای خود مد��، VRAM مصرف میکند، پس مدلی که برای یک طول پرامپت کوتاه بهراحتی جا میشود میتواند همینکه مکالمه رشد میکند حافظهاش تمام شود. برنامههای دیگری که همزمان از حافظهٔ GPU استفاده میکنند نیز میتوانند در همان استخر بخورند. اجرای ollama ps نشان میدهد کدام لایهها واقعاً روی GPU هستند، و کاهش طول زمینه یا تغییر به یک مدل کوچکتر یا کوانتیزهتر هر دو فشار حافظه را کاهش میدهند.
چگونه بفهمم Ollama واقعاً از GPUام استفاده میکند یا بیصدا روی CPU در حال اجراست؟
یک پرامپت اجرا کنید و همزمان nvidia-smi (یا مانیتور معادل فروشندهٔ GPUتان) را در یک ترمینال جداگانه تماشا کنید. اگر بهرهبرداری GPU درحالیکه پاسخی تولید میشود نزدیک صفر باقی بماند، مدل روی CPU در حال اجراست. این حالت شکست هیچ پیام خطایی تولید نمیکند، فقط یک پاسخ بهطرز غیرمعمولی کند، به همین دلیل اغلب مدت طولانی نادیده گرفته میشود.
چرا کانتینر Docker یا وبیوآی من نمیتواند به Ollama متصل شود؟
Ollama بهطور پیشفرض به دلایل امنیتی روی 127.0.0.1 گوش میدهد، و درون یک کانتینر Docker، localhost به خود کانتینر اشاره میکند نه ماشین میزبانی که Ollama روی آن اجرا میشود. ابزارهای کانتینری به http://host.docker.internal:11434 نیاز دارند. برای دسترسی راه دور واقعی از دستگاه دیگری، Ollama باید صریحاً به 0.0.0.0 با متغیر محیطی OLLAMA_HOST متصل شود، که با پیامدهای امنیتی واقعی همراه است چون API Ollama هیچ احراز هویت داخلیای ندارد.
چرا یک نشست عاملی طولانی که از Ollama استفاده میکند ناگهان درست پاسخدادن را متوقف میکند؟
این معمولاً یک سرریز بیصدای طول زمینه است نه یک کرش. پنجرهٔ زمینهٔ پیشفرض Ollama میتواند از آنچه یک وظیفهٔ عاملی چندمرحلهای طولانی واقعاً نیاز دارد کوچکتر باشد، چون آن وظایف تاریخچهٔ انباشتهشده را با هر گام دوباره میفرستند. تنظیم OLLAMA_CONTEXT_LENGTH به مقدار بزرگتر پیش از شروع سرور آن سقف را بالا میبرد، به قیمت مصرف حافظهٔ اضافی بهازای هر مدل بارگذاریشده.
یک مدل خاص عجیب رفتار میکند یا خروجی نامفهوم تولید میکند، اما دیگران خوب کار میکنند. مشکل چیست؟
این مکرراً یک دانلود خراب یا ناقص از یک کشیدن قطعشده است، که Ollama همیشه بهطور خودکار تشخیص نمیدهد. مدل تحتتأثیر را با ollama rm <model-name> حذف کنید و با ollama pull <model-name> دوباره تازه بکشید، که اکثریت بزرگ این موارد را بدون نیاز به هیچ بررسی عمیقتری حل میکند.
چرا Ollama میگوید معماری یک مدل را درست پس از کشیدنش نمیشناسد؟
این وقتی اتفاق میافتد که یک معماری مدل واقعاً جدید سریعتر از آنکه موتور استنتاج نسخهٔ نصبشدهٔ Ollama شما برای شناختنش ساخته شده عرضه میشود. راهحل تقریباً همیشه بهروزرسانی به آخرین انتشار Ollama برای پلتفرم شماست، نه چیزی نادرست در خود فایل مدل. بررسی یادداشتهای انتشار یک مدل جدید برای حداقل نسخهٔ موردنیاز Ollama پیش از کشیدن آن، این را کاملاً اجتناب میکند.